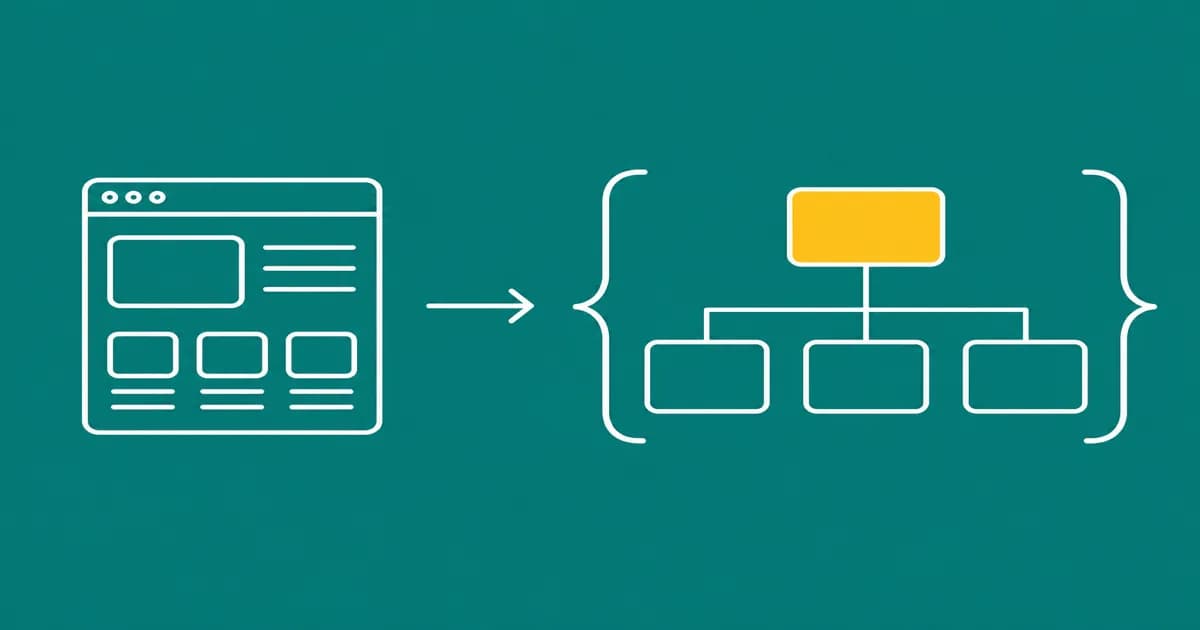
Dane strukturalne to opis treści w formacie, który maszyna odczyta bez zgadywania z układu graficznego. Człowiek widzi, że pogrubiony tekst u góry to tytuł, a data pod nim to data publikacji. System tego nie widzi - dostaje ciąg znaków. Dane strukturalne zamieniają domysł w informację podaną wprost.
Warunek, bez którego reszta nie ma znaczenia
Blok danych strukturalnych musi znajdować się w kodzie strony wysyłanym przez serwer, a nie być doklejany po załadowaniu przez skrypt. Znaczna część robotów modeli nie uruchamia JavaScriptu, więc schema wstrzykiwana przez menedżera tagów albo przez aplikację działającą w przeglądarce dla nich nie istnieje.
Sprawdzenie zajmuje kilkanaście sekund: otwórz podgląd źródła strony i poszukaj w nim bloku oznaczonego jako `application/ld+json`. Jeśli go tam nie ma, a widać go w narzędziach deweloperskich, to znaczy że powstaje dopiero w przeglądarce - i cała praca włożona w opis idzie na marne.
Cztery typy, które realnie pracują
Typów schema jest kilkaset, ale przy treściach poradnikowych i usługowych liczy się garstka. Reszta bywa dodawana z rozpędu i nie wnosi nic poza objętością.
| Organization | Kim jest wydawca: nazwa prawna, identyfikatory rejestrowe, adres, profile. Kotwica tożsamości firmy |
|---|---|
| Person | Kto napisał tekst i czy da się tę osobę zweryfikować. Modele ważą podpisanego autora wyżej niż samą firmę |
| FAQPage | Pary pytanie-odpowiedź w formacie, którego system szuka, budując odpowiedź |
| BreadcrumbList | Miejsce strony w hierarchii serwisu - pomaga rozpoznać, czy to przegląd tematu, czy szczegół |
Do tego dochodzi `Article` przy treściach datowanych, głównie ze względu na datę modyfikacji: świeżość jest jednym z sygnałów branych pod uwagę przy wyborze źródeł. Przy stronach opisujących usługę z ceną sens ma `Service` z `offers`, ale to typ handlowy, nie informacyjny.
Najczęstsze błędy
Pierwszy i najkosztowniejszy: rozjazd między schematem a treścią widoczną. Jeśli w danych strukturalnych figuruje inna nazwa firmy, inna data albo inny autor niż na stronie, system dostaje dwa sprzeczne komunikaty. Skutkiem bywa zignorowanie obu, a nie wybranie jednego.
Drugi: opisywanie treści, której nie ma. Blok `FAQPage` z pytaniami niewidocznymi dla użytkownika jest naruszeniem wytycznych i bywa karany. Zasada jest prosta: schema opisuje to, co na stronie jest, a nie to, co chcielibyśmy, żeby tam było.
Trzeci: traktowanie danych strukturalnych jako całości zadania. Są dobrze udokumentowane i łatwe do zlecenia, więc naturalnie przyciągają uwagę. Ale opisują treść, do której model musi najpierw dotrzeć i którą musi uznać za dobrą odpowiedź. Bez tych dwóch rzeczy najlepiej opisana strona nie zostanie zacytowana.
Jak sprawdzić, czy jest poprawnie
Podstawowe sprawdzenie polega na wklejeniu adresu strony do walidatora danych strukturalnych i przejrzeniu zgłoszonych błędów. Błędy trzeba naprawić; ostrzeżenia zwykle też warto, bo wskazują pola, których brak ogranicza użyteczność opisu.
Drugie sprawdzenie jest ręczne i ważniejsze: przeczytaj to, co jest w schemacie, i porównaj z tym, co widać na stronie. Walidator sprawdza składnię, nie prawdziwość - poprawnie zapisana nieprawda przejdzie bez zastrzeżeń.
Warto to powtarzać po każdej większej zmianie w serwisie, bo migracje i zmiany szablonu potrafią wyciąć bloki schema bez żadnego widocznego objawu. Pozostałe warstwy przygotowania opisuje strona AI-ready.
Jeden graf zamiast kilku osobnych bloków
Typowy błąd wdrożeniowy to kilka niezależnych bloków schema na jednej stronie: osobno artykuł, osobno organizacja, osobno okruszki. Formalnie jest to poprawne, ale każdy blok opisuje wtedy byt, który dla systemu nie ma związku z pozostałymi - autor nie jest powiązany z organizacją, artykuł nie wskazuje wydawcy.
Rozwiązaniem jest jeden blok zawierający wszystkie węzły powiązane identyfikatorami. Wtedy artykuł wskazuje autora, autor wskazuje organizację, a okruszki opisują miejsce tej samej strony w hierarchii. Zamiast czterech oderwanych opisów powstaje jeden spójny obraz - i dokładnie tego szuka system budujący wiedzę o encji.
Powiązanie robi się przez identyfikatory wewnętrzne, nie przez powtarzanie danych. Organizacja opisana raz i wskazywana odnośnikiem z pozostałych węzłów jest jednym bytem; ta sama organizacja wpisana trzy razy z drobnymi różnicami w nazwie bywa odczytana jako trzy różne podmioty.
Przy okazji warto uzupełnić dane identyfikacyjne firmy: numery rejestrowe, pełną nazwę prawną i adres. To najtańszy sposób na rozstrzygnięcie wątpliwości, gdy w tej samej branży działa podmiot o podobnie brzmiącej nazwie - a takie pomyłki należą do najbardziej kosztownych błędów w widoczności.
Od czego zacząć przy istniejącej stronie
Kolejność wdrażania warto oprzeć na tym, co daje najwięcej przy najmniejszym nakładzie. Najpierw organizacja z pełnymi danymi identyfikacyjnymi, bo to jest kotwica tożsamości i wystarczy zrobić ją raz dla całego serwisu.
Potem autor jako osoba z możliwym do sprawdzenia profilem - modele ważą podpisaną osobę wyżej niż samą firmę, a zmiana dotyczy szablonu, nie poszczególnych stron. Na końcu elementy zależne od treści: sekcja pytań i odpowiedzi tam, gdzie realnie istnieje, oraz okruszki odzwierciedlające hierarchię adresów.
Taka kolejność ma tę zaletę, że pierwsze dwa kroki wykonuje się raz i działają na wszystkich podstronach naraz. Trzeci wymaga przejścia hasło po haśle, więc rozkłada się w czasie - i nie blokuje korzyści z dwóch poprzednich.
Dane strukturalne są wzmocnieniem sygnału, nie jego źródłem, i opłacają się dopiero wtedy, gdy strona jest dostępna dla robotów i odpowiada na pytanie. Wdrożone we właściwej kolejności kosztują niewiele i porządkują tożsamość firmy; wdrożone jako pierwsze i jedyne działanie opisują treść, do której nikt nie dociera.
Przy okazji każdej większej przebudowy serwisu warto sprawdzić, czy bloki schema przetrwały zmianę szablonu - migracje potrafią je usunąć bez żadnego widocznego objawu, a wykrycie tego pół roku później oznacza pół roku bez tej warstwy.
To jedno z tych sprawdzeń, które kosztują minutę, a którego pominięcie kosztuje kwartał niewidoczności w warstwie, za którą już zapłacono.